“உனக்கு ஏன் கிளாட் (Claude) என்று பெயர்?”
மனைவியின் பரிந்துரையில் கணினியில் ஆண்டுச் சந்தாவில் அன்று காலையே அனுமதித்திருந்த ஒரு செயற்கை நுண்ணறிவு (AI) உதவியாளரிடம் கேட்டேன். வகுப்பில் என்னைக் கலந்து கொள்ளாமல் அருகில் அமர்த்திவைக்கப்பட்ட புதுப் பையனைப் பரிசீலிக்கும் விரோதம் என் கேள்வியில் இல்லாமலில்லை.
அதை உருவாக்கிய ஆந்த்ரோபிக் (Anthropic) நிறுவனம் இதற்கு அதிகாரப்பூர்வமாக விளக்கம் எதுவும் தரவில்லை என்றது. என்னது பெற்றோர் இட்டது காரணமற்ற பெயரா? எனது இரண்டாவது மூன்றாவது பெயர்களுக்கே காரணங்கள் உண்டே (கொள்ளுதாத்தாக்களினது). புதுப் பையனின் பெயர் காரணத்தை என் கணினிசார் சிற்றறிவு சிலுப்பி நானே ஊகிக்கத் தொடங்கினேன்.
தகவல் கோட்பாட்டின் (information theory) தந்தை கிளாட் ஷானனுக்கு (Claude E. Shannon) செலுத்தும் மரியாதையா? “அவ்வாறே இருக்க வேண்டும் என என்னோடு ஏற்கெனவே அறிமுகமாகிப் பழகிவிட்டப் பெரும்பலரில் சிலபலரால் பரவலாகக் கருதப்படுகிறது” புதுப்பையன் மையமாகப் பதிலளித்தான். என் முதுகில் தட்டிக்கொண்டு மையமாகப் புன்னகைத்தேன்.
நினைத்தேன்! உற்சாகத்தில் மனைவியிடம் என் அறிமுக அறிபலனைப் பிரஸ்தாபிக்கத் தொடங்கி தகவல் என்ட்ரோபி பற்றி நீட்டி முழக்கத் தொடங்கினேன். “இதுக்குதான் கூப்டியா… மதியோட பேசிட்டிருந்ததைப் பாதில கெடுத்து…” தன்னுடைய அலுவல் அறைக்குப் போய்விட்டாள்.
நா-யில்ல இங்க மதியோட பேசிட்டிருந்தேன்… எப்படியோ போட்டும்… அவளுக்குதான் கேட்க கொடுத்துவைக்கலை. அவளிடம் சொல்ல வந்ததை இங்கே உங்களிடம் சொல்லி வைக்கிறேன் முகம் தெரியாத இணைய வாசகர் ஓரிருவரின் அருமை புரியாமலா எழுதுகிறேன். நிற்க.
பெயர் ஏன் பொருத்தம்?
கிளாட் போன்ற பெரு(ம்)மொழி மாதிரிகள் (large language models) அடிப்படையில் செய்வது ஒன்றுதான்: இதுவரை வந்த சொற்களை வைத்து, அடுத்து வரக்கூடிய ஒவ்வொரு சொல்லுக்கும் (அல்லது சொல்லின் துண்டுக்கும் — ‘டோக்கன்’) ஒரு நிகழ்தகவைக் (probability) கணிப்பது. ஒரு மொழியில் மனிதர் எழுதிய உரையை வாசிக்கையில் அவை சராசரியாக எவ்வளவு குறைவாக ‘வியப்படைகின்றன’ என்பதை அளந்தே அவற்றைப் பயிற்றுவிக்கிறார்கள். அந்த வியப்பின் அளவு (surprisal) ஷானனின் கணக்கு. மனித எழுத்தைக் கண்டு அரிதாகவே வியப்படையும் LLM-AI மாதிரி, ஷானனின் பொருளில், அந்த மொழியைப் பற்றி நிறையக் கற்றுக்கொண்டுவிட்டது.
அடுத்து அரைமணி இவன் விளக்கப்போவது என்ன நமக்கு வேண்டுமா இல்லையா என்பதை என் முதல் வாக்கிய விளக்கத்திலேயே அனுமானித்து என் மனைவி தன் மதியோடு பேசப் போய்விட்டாளே. இதுவே மனித அறிவு. என்னைப் பற்றிய வியப்பு துளியும் இல்லாதவள் என் மனைவி. அதாவது நான் எதை எவ்வாறு பேசப்போகிறேன் என்பதைத் துல்லியமாக அனுமானிக்க முடிந்தவள். என் பேச்சைப் பொறுத்தவரை, நோ சர்ப்ரைஸ் – அவளுக்கு. இதையே செயற்கை நுண்ணறிவு நம்மிடம் செய்ய முயல்கிறது. (அது இன்றும் குறையாக இதைச் செய்வதிலேயே நாம் வியப்படைகிறோம்.)
ஷானனே இந்த விளையாட்டை முன்கூட்டியே ஆடிப் பார்த்தவர். 1951-இல், ஓர் உரையின் அடுத்த எழுத்தை மனிதர்களை ஊகிக்கச் சொல்லி, அச்சிட்ட ஆங்கிலம் ஓர் எழுத்துக்குச் சுமார் ஒரு பிட் (bit) தகவலையே சுமக்கிறது என்று மதிப்பிட்டார். எல்லா எழுத்துகளும் (இடைவெளி உட்பட) சம வாய்ப்புடன் வந்தால் இது சுமார் 4.75 பிட்டாக இருந்திருக்கும். இந்த இடைவெளிதான் மொழியின் மிகைமை (redundancy). அந்த மிகைமைதான் ஊகிப்பதை, ஆகவே இந்த கிளாட்-வகை LLM-AI-களையும், சாத்தியமாக்குகிறது.
ஆக, என் கேள்விக்கு ‘புதுப்பையன்’ கிளாட் பதில் சொன்னபோது (அதன் “அவ்வாறே…” எனத் தொடங்கும் பதிலில்), என் வியப்பைக் குறைவாக வைத்திருக்கும்படி ஒவ்வொரு சொல்லாகத் தேர்ந்தெடுத்துக்கொண்டிருந்தது. அதன் பெயருக்குரியவர் அந்தச் சிக்கனத்தை மெச்சியிருப்பார்; நீளத்தை அல்ல.
கணினிசார் தமிழார்வல மின்னுலாவிகளுக்கு இதோ இலவசமாக ஓர் ஆய்வுப் பரிந்துரை: தமிழ் மொழியில் ஓர் எழுத்துக்கு எத்தனை பிட்? யாராவது கணக்கிட்டிருக்கிறார்களா? ஆய்வுக் கட்டுரை வரை கொண்டுசெல்லும் அளவிற்கு ஆர்வமிருந்தால் என்னிடம் இதற்குச் செய்ய வேண்டிய ஆய்வுப்பணிக்கான அடுத்த கட்டங்களை ஆலோசிக்கலாம்.
சரி, தகவல் என்ட்ரோபி என்றால் என்ன? அடிப்படையை மட்டும் விளக்குகிறேன்.
தகவலும் நிச்சயமின்மையும்
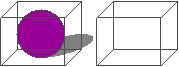
கீழே உள்ள இரண்டு பெட்டிகளில் ஏதோ ஒன்றில் ஒரு பந்து இருக்கிறது. எந்தப் பெட்டியில் என்று நீங்கள் கண்டுபிடிக்க வேண்டும். என்னிடம் கேள்விகள் கேட்கலாம்; நான் ‘ஆம்’ அல்லது ‘இல்லை’ என்று மட்டுமே பதில் சொல்வேன் — பால்யத்தில் ஆடும் ‘இருபது கேள்விகள்’ விளையாட்டு போல.
படம் 1
கேள்வி எதுவும் கேட்பதற்கு முன், பந்து எந்தப் பெட்டியில் இருக்கிறது என்று உங்களுக்குத் துப்பே இல்லை. அதாவது நீங்கள் நிச்சயமின்மையில் (uncertainty) இருக்கிறீர்கள்; சரியாக முடிவெடுக்கத் தேவையான தகவல் (information) உங்களிடம் இல்லை. கேள்வி கேட்டுப் பதில் பெற்றதும் — இங்கே ஒரு கேள்வியே போதும் — தகவல் கிடைக்கிறது; நிச்சயமின்மை நீங்குகிறது. இனி உங்கள் தேர்வு குருட்டு ஊகம் அல்ல; காரணத்தின் அடிப்படையிலானது. நான் பொய் சொல்லாதவரை.
ஒன்றை நினைவில் கொள்ள வேண்டும். இங்கே ‘தகவல்’, ‘நிச்சயமின்மை’ என்ற சொற்கள், எழுத்துகளின் ஒரு தொடருக்கு என்ன ‘பொருள்’ (meaning) என்பதை அளப்பதில்லை; ஒரு மொழியின் இலக்கணத்தையும் கணிதமாகச் சொல்வதில்லை. பலவற்றிலிருந்து ஒன்றைத் தேர்ந்தெடுப்பதில் உள்ள நிச்சயமின்மையை மட்டுமே அளக்கின்றன.
சுருக்கமாக: நிச்சயமின்மை குறைந்தால், தகவல் கூடுகிறது.
இந்த நிச்சயமின்மையை எப்படி அளப்பது? இதற்கு ‘பிட்’ (bit) வேண்டும். சம வாய்ப்புள்ள இரண்டில் ஒன்றைத் தேர்ந்தெடுக்கத் தேவைப்படும் தகவலின் அளவே ஒரு பிட். கணினிப் பேச்சில் பிட் என்பது 0 அல்லது 1 மட்டுமே; இங்கே அது பின்ன எண்ணாகவும் இருக்கலாம் — 1.58 பிட் என்பதுபோல.
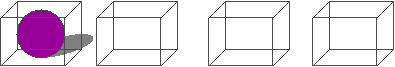
இரண்டு பெட்டிகள் என்றால் குறைந்தது ஒரு கேள்வி — ஒரு பிட். நான்கு பெட்டிகள் (படம் 2), பந்து எதில் வேண்டுமானாலும் சம வாய்ப்புடன் இருக்கலாம் என்றால், குறைந்தது இரண்டு கேள்விகள் — இரண்டு பிட். (“இடப்பக்க இரண்டில் ஒன்றிலா?” “ஆம்.” “முதலாவதிலா?” “ஆம்.” பந்து கிடைத்துவிட்டது.)
படம் 2
எட்டுப் பெட்டிகள் என்றால் மூன்று கேள்விகள் — மூன்று பிட். ஒவ்வொரு ‘ஆம்/இல்லை’ பதிலும் சாத்தியங்களைப் பாதியாக்குவதால், M பெட்டிகளுக்கு பிட். எல்லாச் சாத்தியங்களையும் கணக்கில் கொண்டால், பிட்டுகளின் எண்ணிக்கையே தேவைப்படும் மிகக் குறைந்த கேள்விகளின் எண்ணிக்கை.
ஆக, எட்டுப் பெட்டிகளில், கேள்வி கேட்பதற்கு முன் நிச்சயமின்மை 3 பிட்; விடை தெரிந்ததும் பூஜ்யம். நிச்சயமின்மை குறைந்த அளவே நாம் பெற்ற தகவல்: 3 பிட்.
‘என்ட்ரோபி’ என்ற பெயர் வந்த கதை
இந்த நிச்சயமின்மைக்குத்தான் தகவல் என்ட்ரோபி அல்லது ஷானன் என்ட்ரோபி என்று பெயர். 1948-இல் வெளியான ஷானனின் “A Mathematical Theory of Communication” கட்டுரை தகவல்தொடர்புத் துறையையே புரட்டிப்போட்டது (signal-to-noise ratio, channel capacity என்றெல்லாம் உங்கள் எலக்ட்ரானிக்ஸ் பொறியாளர் நண்பரிடம் கேட்டுப் பாருங்கள்).
கதை இப்படிப் போகிறது. தன் கருத்தைக் கணித வடிவில் எழுதிய பின்னர், ஷானன் தன் நண்பர் ஜான் வான் நியூமனிடம் (John von Neumann) இதை என்ன பெயரிட்டு அழைக்கலாம் என்று கேட்டாராம். “என்ட்ரோபி-நு வை. அது என்னனு யாருக்கும் சரியாத் தெரியாது; எந்த விவாதத்திலும் உனக்கே வெற்றி” வான் நியூமன் பதில். ஷானனும் அப்படியே செய்து, தன் கட்டுரையில் ‘நிச்சயமின்மை’ என்ற சொல்லையும் அதே பொருளில் பயன்படுத்தினார்.
ஆனால் இந்தப் பெயர் நிறையக் குழப்பத்தையும் கொண்டுவந்தது. தகவல் என்ட்ரோபி அளக்கப்படுவது ஒரு குறியீட்டுக்கு (symbol) இத்தனை பிட் என்று; வெப்ப இயக்கவியல் (thermodynamics) என்ட்ரோபி () அளக்கப்படுவது ஜூல்/கெல்வின் என்று. கணித வடிவில் ஒத்திருந்தாலும் இரண்டையும் ஒன்றென்று குழப்பிக்கொள்ளக் கூடாது. ஆண்டுகளாக வெப்ப அறிவியல்-சார் கற்பிப்பவனாக இதை அழுத்திச் சொல்ல வேண்டியிருக்கிறது.
இவ்வளவு வரை தொடர்ந்து வந்திருப்பீர்கள். இன்னமும் விரிவாக அடுத்த கட்ட விளக்கம் வேண்டுமென்றால் சொல்லுங்கள் செய்யலாம்… அடுத்த கட்டுரையில்.
சரி, அது கிடக்கட்டும் சார். முடிஞ்சப்ப எழுதுங்க முடிஞ்சா வாசிக்கிறோம்… புரிகிறது வாசகர்களே. மனைவி குறிப்பிட்ட மதி யார்? அதுதானே நமைச்சல். அவளுடைய ChatGPT ஆப்பை அவ்வாறுதான் அழைக்கிறாளாம். பதி பேச்சின் ‘மதி’ப்பு அறிந்தவளல்லவா.
கணிதத்துடன் கூடிய என்னுடைய விரிவான ஆங்கிலக் கட்டுரை: Information Entropy (arunn.prof).
மேற்கோள்கள்
- C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal, 27, 1948.
- C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal, 30, 1951.
- M. Tribus, E. C. McIrvine, “Energy and Information,” Scientific American, 225(3), 1971.
- Boltzmann’s entropy formula - https://en.wikipedia.org/wiki/Boltzmann’s_entropy_formula